GPT-OSS 120B를 8GB VRAM, 메모리 64GB로 구동시켜볼 수 있다하여 다음 레딧글을 참고해서 시도해봤습니다.
https://old.reddit.com/r/LocalLLaMA/comments/1mke7ef/120b_runs_awesome_on_just_8gb_vram
.
테스트에 사용한 노트북 사양입니다.
CPU AMD Ryzen 7 8845HS w/ Radeon 780M Graphics (3.80 GHz)
Geforce RTX 4060 8G
시스템 메모리 64GB
.
2025. 8. 15 최초작성
2025. 8. 16 스레드에서 한 분이 실행결과가 CPU에서 돌린것 수준이라하셔서 다시 확인해보니 그런거 같아서 다시 시도해봤습니다.
2025. 8. 31 버전차이로 옵션 변경됨.
.
영상으로도 제작했지만 주요 명령은 블로그 글을 참고 해야 합니다.
.
참고한 레딧글에서 llama.cpp를 사용한걸 확인하고 깃허브 저장소를 찾았습니다.
https://github.com/ggml-org/llama.cpp
.
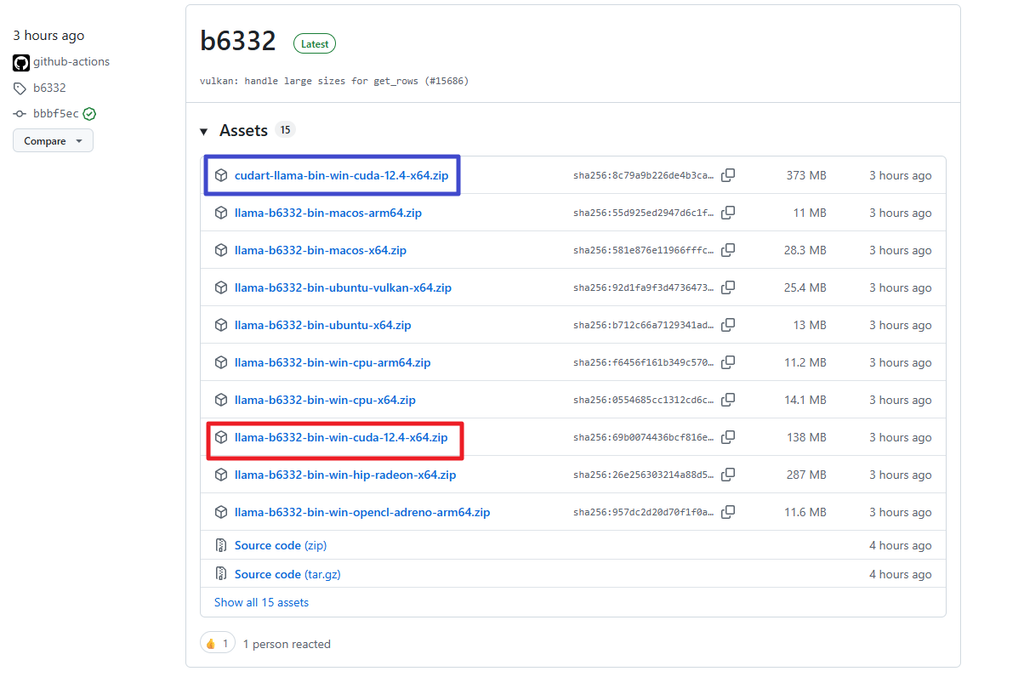
최근에 릴리즈된 것을 확인해보니 윈도우용이 압축파일로 제공되네요. 빨간 사각형으로 표시한 llama cpp 파일을 다운로드 받았습니다. 그리고 CUDA를 사용하면 필요할거 같아 파란색 사각형으로 표시한 것도 다운로드 받았습니다.
https://github.com/ggml-org/llama.cpp/releases
.
압축을 풀었더니 여러 파일들이 있네요.
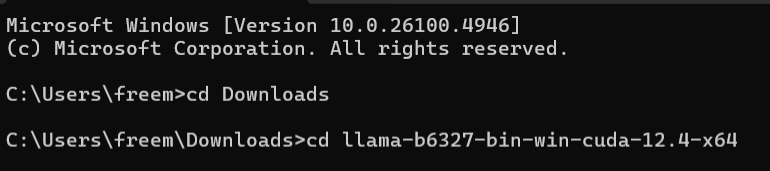
명령 프롬프트에서 해당 폴더로 이동합니다.
.
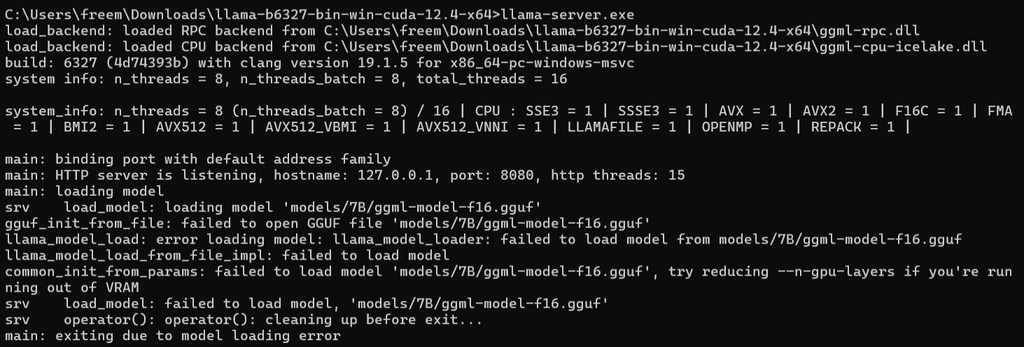
llama-server를 실행시켜보니 CPU를 사용하는 듯 보입니다.
.
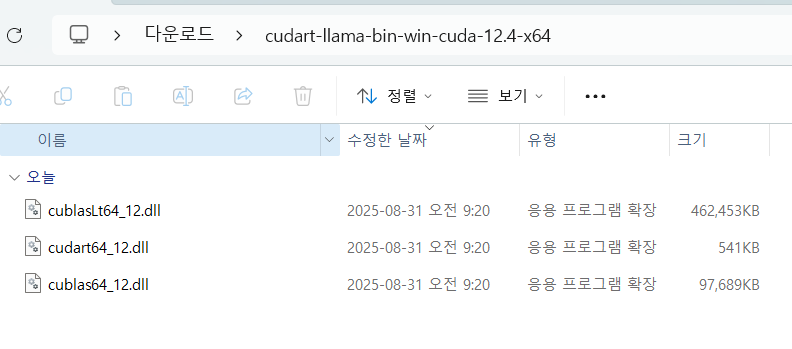
앞에서 다운로드 받았던 cudart-llama-bin-win-cuda-12.4-x64.zip 파일을 압축풀어 해당 폴더에 넣어보고 다시 실행해봅니다.
압축파일엔 다음 파일들이 있습니다.
.
llama-server를 다시 실행시켜본 결과입니다. 예상대로 CUDA를 사용가능하게 된 걸로 보입니다. 앞에서 보인거랑 메시지에 CUDA 관련 내용이 있습니다.
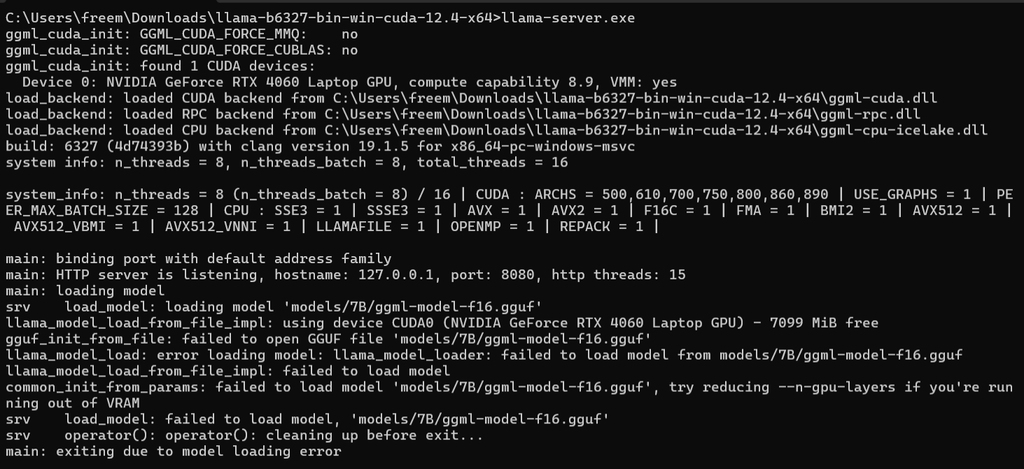
.
이제 모델이 필요하다 싶어 참고한 레딧글에서 사용한 gpt-oss-120b-mxfp4-00001-of-00003.gguf라는 모델을 구글에서 우선 찾아보니 다음 링크에 있네요.
https://huggingface.co/ggml-org/gpt-oss-120b-GGUF
.
다음 명령을 사용하여 모델을 다운로드 하였습니다. 좀 시간이 걸립니다.
| llama-cli -hf ggml-org/gpt-oss-120b-GGUF |

.
진행화면이 다음처럼 보여서 혼란스럽지만 다운로드는 되는게 분명해보였습니다. 로그 시작 부분을 확인해보니 예상시간이 17분이지만… 네트워크 속도에 따라 다를 수 있을 듯합니다.
.
다운로드가 완료되면 다음 화면이 보이는데 Ctrl + C를 눌러 종료시킵니다. 종료시키기전 LLM에게 질문을 할 수 있는 것으로 보이지만 해보진 않았습니다. CUDA 가속을 활성화해준 DLL을 복사하기 전에 다운로드를 시작했기 때문에 스크린샷엔 CPU만 사용가능한걸로 보입니다.
.
다운로드 받은 모델은 현재 디렉토리에 없고 다음 경로에 있습니다. 그래서 아래 명령어 실행시 모델 파일 앞에 $LLAMA_MODEL_DIR를 추가하는 듯합니다. everything(https://www.voidtools.com/ko-kr/ )이란 프로그램을 사용하면 파일 위치를 찾을 수 있습니다.
| C:\Users\freem\AppData\Local\llama.cpp\ggml-org_gpt-oss-120b-GGUF_gpt-oss-120b-mxfp4-00001-of-00003.gguf |
.
이제 다음 명령으로 모델을 실행할 수 있습니다. 다음 두 명령의 차이는 n-cpu-moe 옵션값 차이입니다.
레딧글에서 5G VRAM에서 실행했다는 명령입니다. gpt-oss-120b 모델은 36개의 MOE 블록을 가지고 있는데 cpu-moe가 36이란 것은 모든 MOE가 CPU에서 실행됨을 의미합니다.
| llama-server -m $LLAMA_MODEL_DIR/gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 36 --n-gpu-layers 999 -c 0 -fa --jinja --reasoning-format none --host 0.0.0.0 --port 8502 --api-key "dummy" |
.
레딧글에서 8G VRAM에서 실행했다는 명령입니다. gpt-oss-120b 모델은 36개의 MOE 블록을 가지고 있는데 cpu-moe가 28이란 것은 대부분의 MOE는 CPU에서 실행되고 일부 MOE는 GPU에서 실행됨을 의미합니다.
| llama-server -m $LLAMA_MODEL_DIR/gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 28 --n-gpu-layers 999 -c 0 -fa --jinja --reasoning-format none --host 0.0.0.0 --port 8502 --api-key "dummy" |
.
레딧글에서 옵션을 설명한 내용입니다.
| ~/build/llama.cpp/build-cuda/bin/llama-server \ -m $LLAMA_MODEL_DIR/gpt-oss-120b-mxfp4-00001-of-00003.gguf \ --n-cpu-moe 36 \ # 이 모델은 36개의 MOE 블록을 가지고 있습니다. cpu-moe 36은 모든 MOE가 CPU에서 실행됨을 의미합니다. 일부 MOE를 GPU로 이동시키도록 조정할 수 있지만, 그렇게 해도 그리 빨라지지는 않습니다. --n-gpu-layers 999 \ # 나머지 모든 것을 GPU에서 처리, 약 8GB 사용 -c 0 -fa \ # 최대 컨텍스트 길이 (128k), 플래시 어텐션 사용 --jinja --reasoning-format none \ --host 0.0.0.0 --port 8502 --api-key "dummy" |
.
두번째 명령을 사용하여 실행해봅니다. 단 여기에선 릴리즈된 것을 다운로드하여 사용하기 때문에 모델 파일 앞에 붙어있는 $LLAMA_MODEL_DIR 환경변수가 정의 안되어 있습니다. 앞에서 찾은 모델 위치를 사용합니다. 윈도우에선 같은 위치에 다운로드 될거라고 생각되지만 문제 있으면 앞에서 사용한 everything 프로그램으로 모델 위치를 찾아보세요.
.
2025. 8. 31 사용하는 llama cpp 버전이 올라간후 일부 옵션을 제거하고 옵션을 변경해야 했습니다.
| llama-server -m C:\Users\freem\AppData\Local\llama.cpp\ggml-org_gpt-oss-120b-GGUF_gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 28 --n-gpu-layers 999 -c 0 --reasoning-format none --host 127.0.0.1 --port 8502 |
.
2025. 8. 16
스레드에서 한 분이 CPU에서 돌린거랑 비슷한 수준이라며 Attention만 GPU에서 돌린걸로 시도해보라고 하셔서 클로드를 사용하여 옵션을 변경해봤습니다. 총 5가지 명령이 있는데 각각의 실행 결과는 아래쪽에서 기존 결과와 같이 보여드립니다.
똑같은 질문을 했지만 서로 다른 답변을 해서 차이가 생길 수 도 있다 싶습니다.
.
똑같은 환경인데 문제가 생겨서 다음 두 옵션을 변경했습니다.
네트워크 환경이 바뀌어서인지 실행결과 The drive at '/mnt/main: server is listening on http://0.0.0.0:8502 - starting the main loop 처럼 출력되어 옵션을 추가로 변경했습니다.
.
질문시 Invalid API Key 에러도 나서 API KEY 옵션도 제거했습니다.
| llama-server -m C:\Users\freem\AppData\Local\llama.cpp\ggml-org_gpt-oss-120b-GGUF_gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 28 --n-gpu-layers 0 -c 0 --jinja --reasoning-format none --host 127.0.0.1 --port 8502 |
.
클로드에게 추가로 최적화 옵션을 알려달라하여 얻은 명령입니다.
| llama-server -m C:\Users\freem\AppData\Local\llama.cpp\ggml-org_gpt-oss-120b-GGUF_gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 28 --n-gpu-layers 20 -c 0 -fa --jinja --reasoning-format none --host 127.0.0.1 --port 8502 -b 512 --mlock |
클로드에게 더 최적화 해달라고 해봤습니다. 2025.8.31 기준으로 -fa와 --jinja를 제거해야 했습니다.
| llama-server -m C:\Users\freem\AppData\Local\llama.cpp\ggml-org_gpt-oss-120b-GGUF_gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 28 --n-gpu-layers 999 -c 0 --reasoning-format none --host 127.0.0.1 --port 8502 -b 1024 --mlock |
.
GPU를 사용안하나 싶어 확인해보니 GPU 메모리를 사용하고 있습니다.
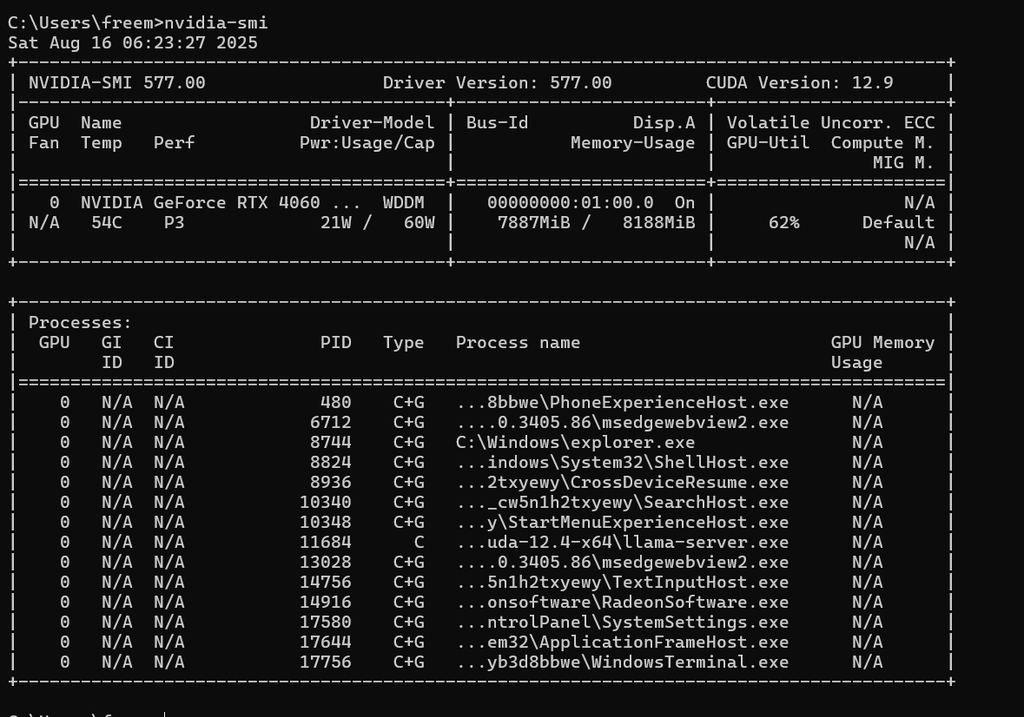
.
추가로 CPU만 사용한 경우도 해봤습니다. 64G 메모리를 사용하도록 -c 32768 옵션을 추가했습니다. 클로드에게 CPU만 사용하게 해달라고 했지만 로그를 보니 CUDA 관련 할당이 보입니다.
| llama-server -m C:\Users\freem\AppData\Local\llama.cpp\ggml-org_gpt-oss-120b-GGUF_gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 28 --n-gpu-layers 0 -c 32768 --jinja --reasoning-format none --host 127.0.0.1 --port 8502 -b 512 --mlock -t -1 |
.
cuda 관련 DLL을 제거 하고 같은 명령으로 다시 해봤습니다. 이번엔 GPU를 사용안하고 있네요. 똑같은 명령을 사용합니다.
| llama-server -m C:\Users\freem\AppData\Local\llama.cpp\ggml-org_gpt-oss-120b-GGUF_gpt-oss-120b-mxfp4-00001-of-00003.gguf --n-cpu-moe 28 --n-gpu-layers 0 -c 32768 --jinja --reasoning-format none --host 127.0.0.1 --port 8502 -b 512 --mlock -t -1 |
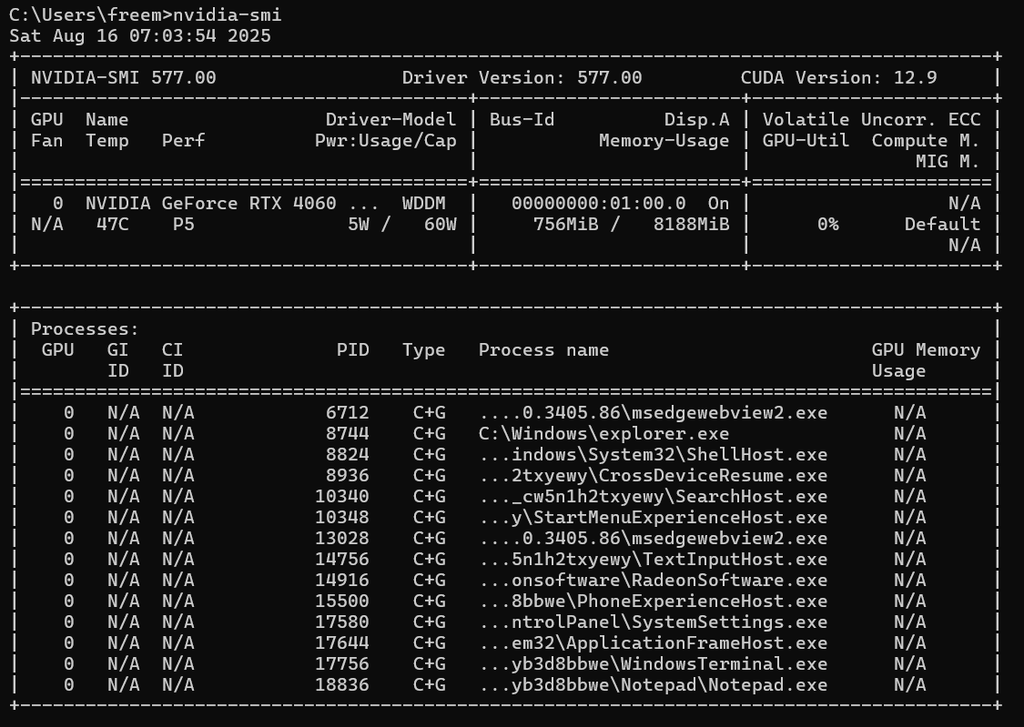
.
문제 없이 실행되는데 다음 화면에서 좀 대기하네요.
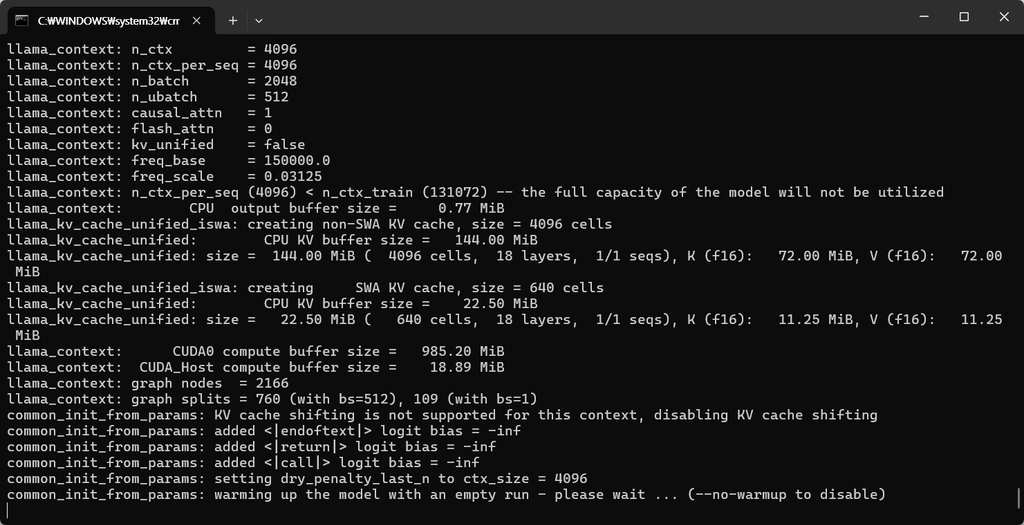
.
잠시 후 다음 메시지가 보이면서 접속 가능한 URL을 알려줍니다. 여기에선 http://127.0.0.1:8080 입니다. 웹브라우저로 접속해봅니다.
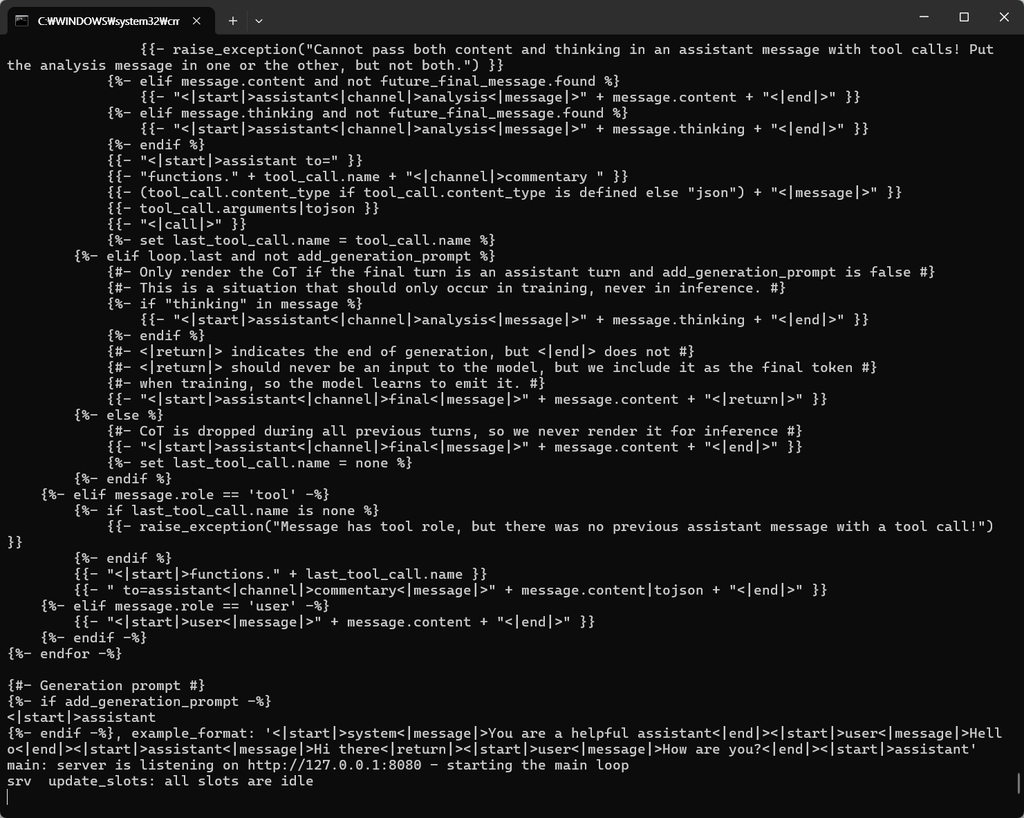
.
다음처럼 보입니다. 질문을 해봅니다.
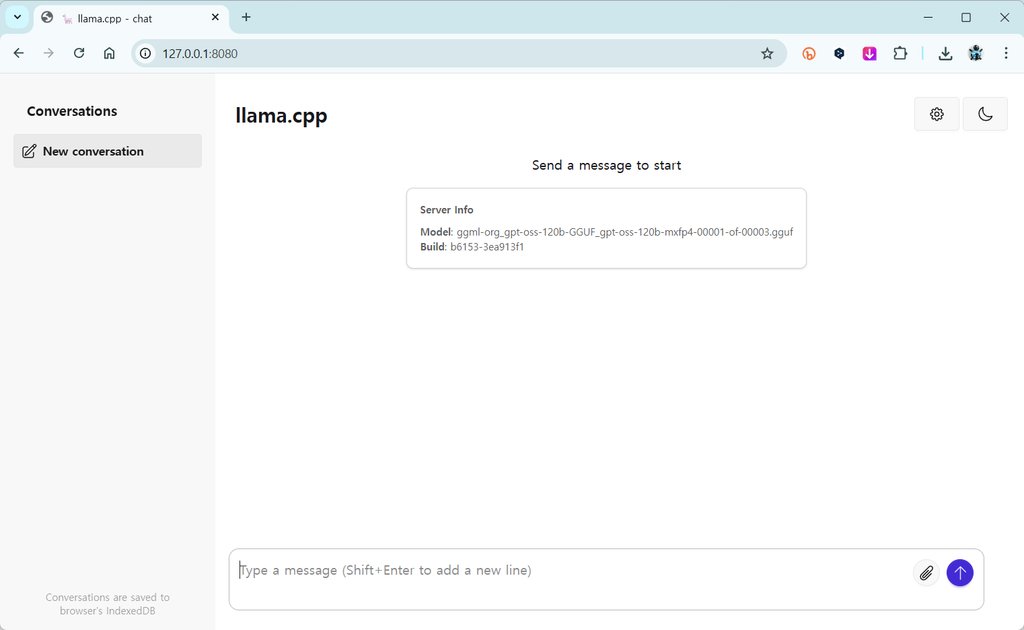
.
답변이 바로 나오지는 않네요. 옵션에 따라 달라집니다.
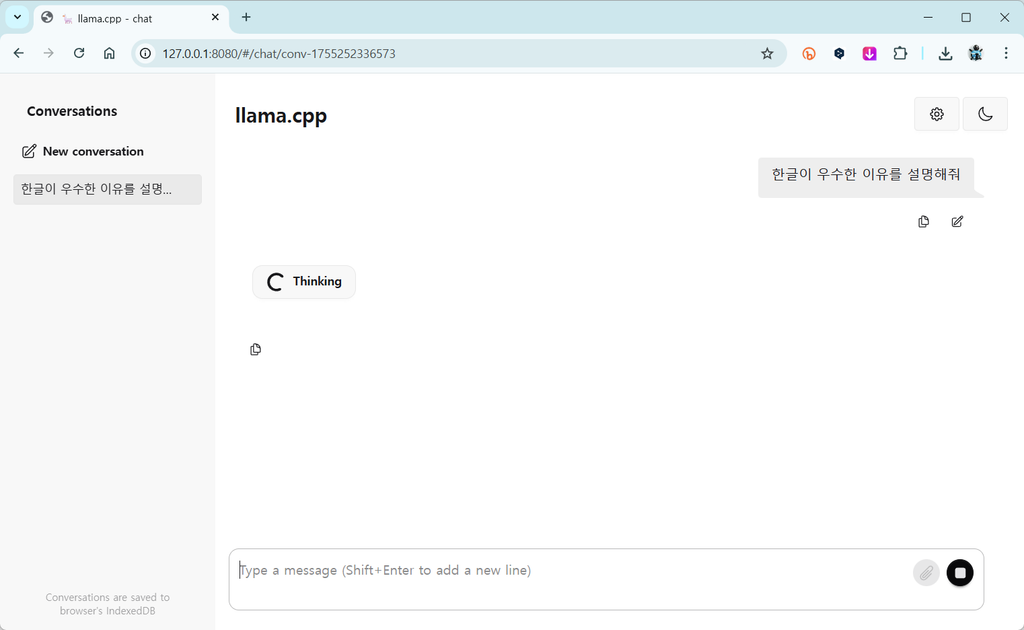
.
일분 정도 기다렸나 답변이 시작되었는데 빠른 편이 아니라서 모든 답변을 얻는 데 까지 꽤 걸릴듯합니다. 옵션에 따라 달라집니다.
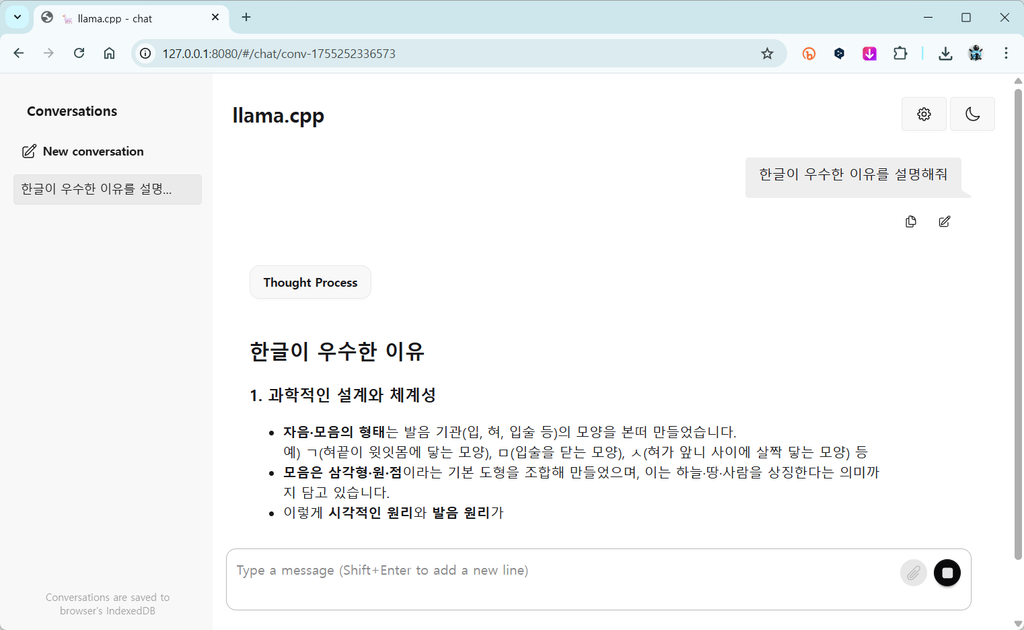
.
다음 질문을 모두 얻는데 2분 내로 걸린듯합니다.옵션에 따라 달라집니다.
.
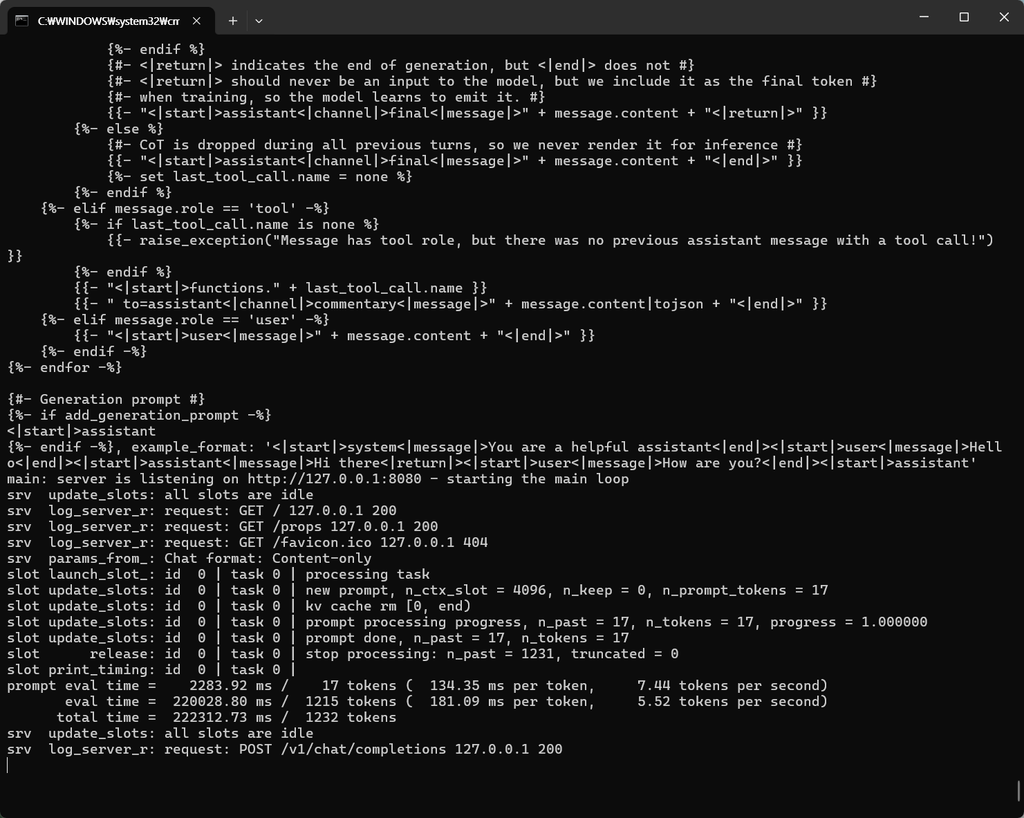
답변완료후 명령 프롬프트 상태입니다. 걸린 시간이 출력되어 있습니다.
| prompt eval time = 2283.92 ms / 17 tokens ( 134.35 ms per token, 7.44 tokens per second) eval time = 220028.80 ms / 1215 tokens ( 181.09 ms per token, 5.52 tokens per second) total time = 222312.73 ms / 1232 tokens |
.
2025. 8. 16
추가 테스트 결과입니다.
.
Attention만 GPU에서 돌리는 걸로 다시 실행할 경우 실행시간입니다.
| prompt eval time = 136670.48 ms / 78 tokens ( 1752.19 ms per token, 0.57 tokens per second) eval time = 487443.87 ms / 1596 tokens ( 305.42 ms per token, 3.27 tokens per second) total time = 624114.36 ms / 1674 tokens |
.
추가로 클로드에게 최적화된 옵션을 알려달라하여 다시 실행한 경우 실행시간입니다.
| prompt eval time = 10019.25 ms / 78 tokens ( 128.45 ms per token, 7.79 tokens per second) eval time = 255915.06 ms / 1854 tokens ( 138.03 ms per token, 7.24 tokens per second) total time = 265934.32 ms / 1932 tokens |
.
클로드에게 추가로 최적화 해달라고 한 경우 실행시간입니다.
| prompt eval time = 9724.32 ms / 78 tokens ( 124.67 ms per token, 8.02 tokens per second) eval time = 154393.32 ms / 1343 tokens ( 114.96 ms per token, 8.70 tokens per second) total time = 164117.64 ms / 1421 tokens |
.
CPU만 사용한 경우 실행시간입니다. CPU만 사용한 결과로 보기 힘들어 보입니다.
| prompt eval time = 9727.71 ms / 78 tokens ( 124.71 ms per token, 8.02 tokens per second) eval time = 184597.39 ms / 1483 tokens ( 124.48 ms per token, 8.03 tokens per second) total time = 194325.11 ms / 1561 tokens |
.
cuda 관련 DLL을 제거 하고 CPU만 사용한 경우와 같은 명령으로 다시 해본 경우 실행시간입니다.
| prompt eval time = 19287.76 ms / 78 tokens ( 247.28 ms per token, 4.04 tokens per second) eval time = 505948.49 ms / 1554 tokens ( 325.58 ms per token, 3.07 tokens per second) total time = 525236.25 ms / 1632 tokens |
.
Ctrl + C를 눌러 중지시킬 수 있습니다.
이게 가능한게 원래는 GPU 메모리에 모두 올려야 하지만 일부를 시스템 메모리에 올려서인 듯합니다. 그로인해 적은 GPU 메모리로도 실행은 가능해지지만 속도가 느려질 수 밖에 없어보이네요. 시스템 메모리가 64GB인게 최소 사양이고 쓸만한 시스템 메모리 크기는 96GB라고 합니다.
.
다음은 레딧글을 번역한 일부 내용입니다.
llama-cpp의 --cpu-moe 옵션을 활용해 MOE 전문가 레이어를 CPU에서 처리하고, 주의(attention) 레이어만 GPU에 오프로드해 5~8GB VRAM으로 빠른 프리필 성능을 구현
GPU에는 KV 캐시, Attention 가중치·활성값, 라우팅 테이블, LayerNorm 등 비전문가 파라미터만 상주해 메모리 사용량이 낮음
RTX 3060Ti급 GPU와 64GB~96GB 시스템 RAM으로도 120B 모델을 가볍게 구동 가능하며, BF16 지원 GPU(RTX 3000+)에서 최적 성능을 발휘함
5GB VRAM 사용 시 토큰당 8.15ms(122.66 토큰/초) 성능을 기록했고, 8GB VRAM 사용 시 7.44ms(134.44 토큰/초)까지 개선됨